这两年会议直播不加实时字幕,甲方都不好意思对外发了。尤其学术会、发布会,字幕既是无障碍刚需,也是短视频二次传播的基础。但真上手做,你会发现难点根本不是"能不能出字",而是"出的字对不对"。
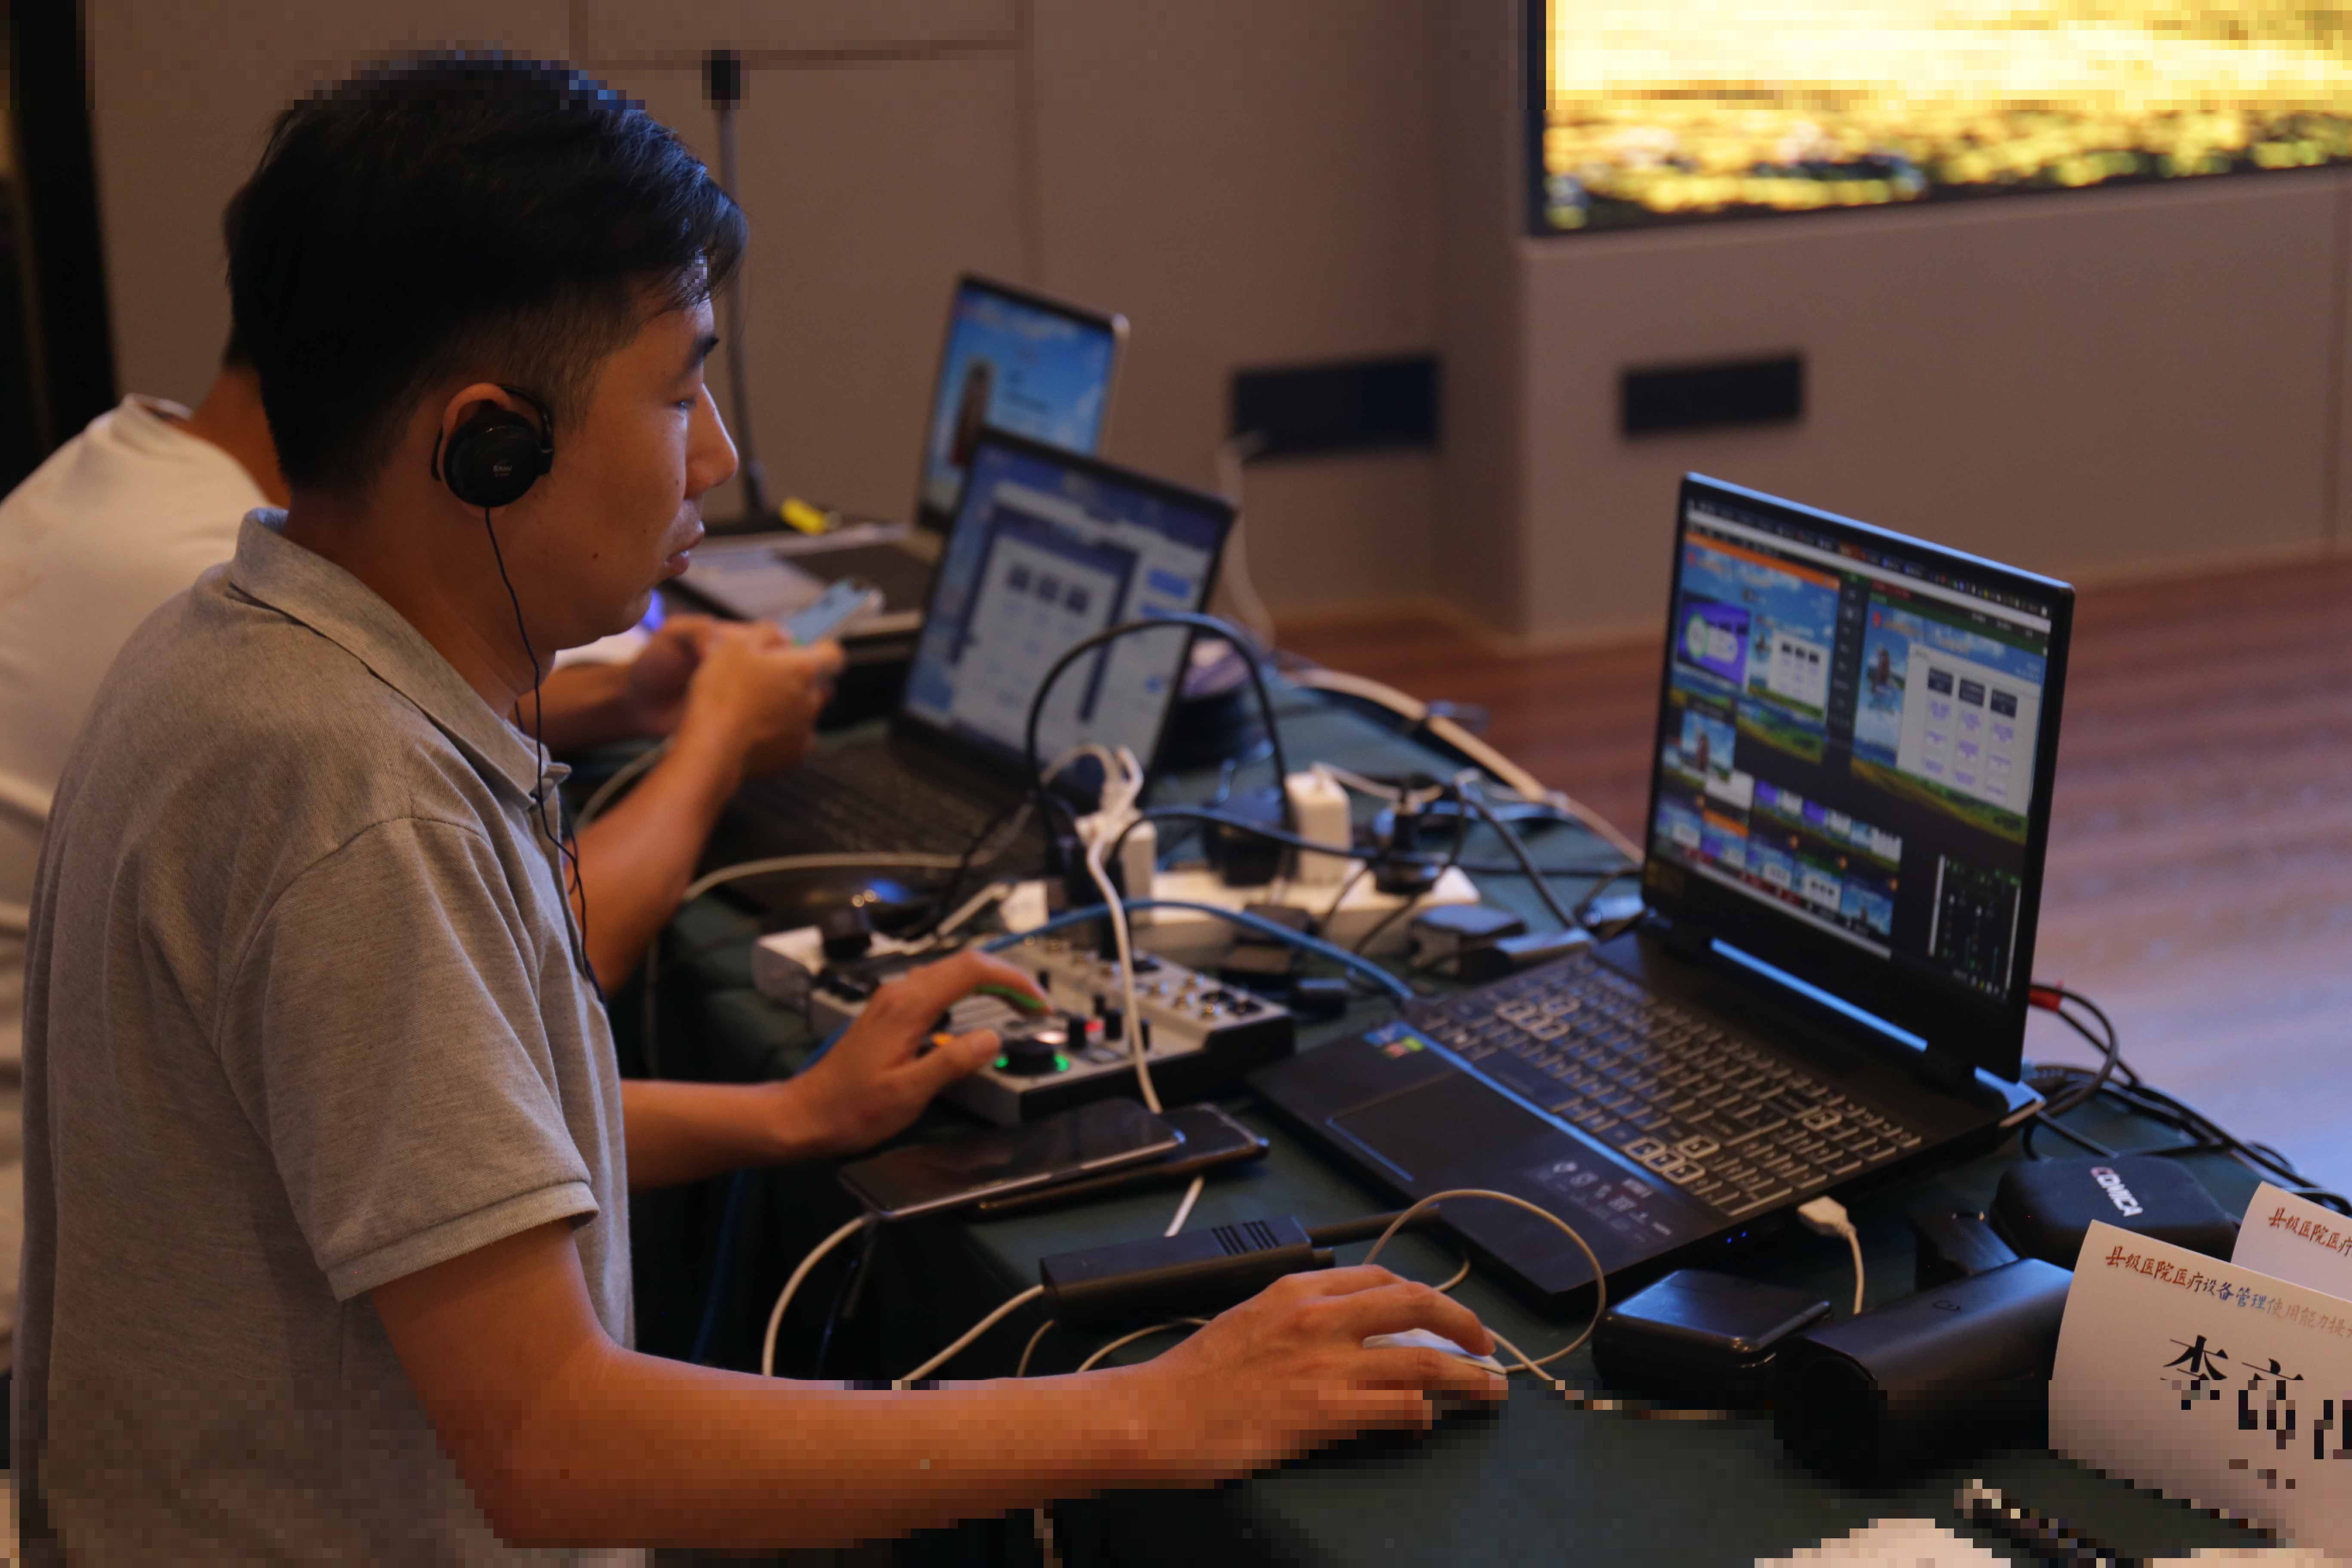
通用ASR(自动语音识别)的准确率现在确实高,日常对话能到九成以上。可一到专业会议就露怯:医学会的"房间隔缺损"、金融圈的"久期"、半导体的"光刻胶",通用模型经常给你写成谐音词,观众一看字幕就出戏。我们踩过一次真翻车:一场医疗论坛,ASR把"介入"识别成"介入"(同音没事),却把"支架"写成"纸架",弹幕当场有人开玩笑,主办方脸都绿了。从那以后,我们的解法分两层:第一层是热词库,开播前把嘉宾PPT、议程、行业术语表喂进去,让识别引擎优先匹配这些词,准确率能明显抬一截;第二层是人工兜底,导播台旁边坐一个速记,专门盯字幕,发现错词立刻改。
光有热词还不够,因为现场常有即兴发挥。所以我们一般把实时字幕设成"机器先出、人工秒改"的模式,延迟控制在两三秒内,观众体感不到。回放再跑一遍精校,把现场的口误、重复、口头禅清掉,做成干净字幕版,方便学员回看和点播。
多语种同传是另一回事。一场有外宾的会议,要的是"识别—翻译—渲染"三段并行:语音先被识别成原文,原文进翻译引擎出目标语言,再送渲染层叠到画面上。这里最怕串行——任一段慢了,字幕就滞后半句。我们会把识别和翻译拆成两条独立流水线,翻译用低延迟模型,宁可偶尔少翻一句,也不让整条字幕卡死。中译英一般能压在四秒左右出字,再快就容易丢语义。
还有个小但重要的点:字幕样式。很多团队直接套默认白字黑边,结果放到手机小屏上糊成一片。我们按平台分两套:大屏用细描边,手机用粗描边加半透明底,字号跟着画面分辨率走,保证最后一排观众和地铁上刷手机的人都能看清。字幕也是内容的一部分,别让它拖了直播的后腿。
顺带说个容易被忽视的复用:字幕文本本身就是资产。精校后的逐字稿可以转成图文速记发公众号,关键词还能喂回搜索引擎做长尾收录。一场会议的直播结束,字幕还在持续给官网带流量。所以别把字幕当一次性消耗,导出来、存好、二次分发,性价比很高。
一句话总结:实时字幕不是接个API就完事,热词库、人工校对、多语种流水线、样式适配,少了哪块都出洋相。本文由摄行科技活动影像团队整理。